
OmniStudio 本地 AI 模型平台

在本机下载、管理与运行模型,让 AI 接入你的日常工作。

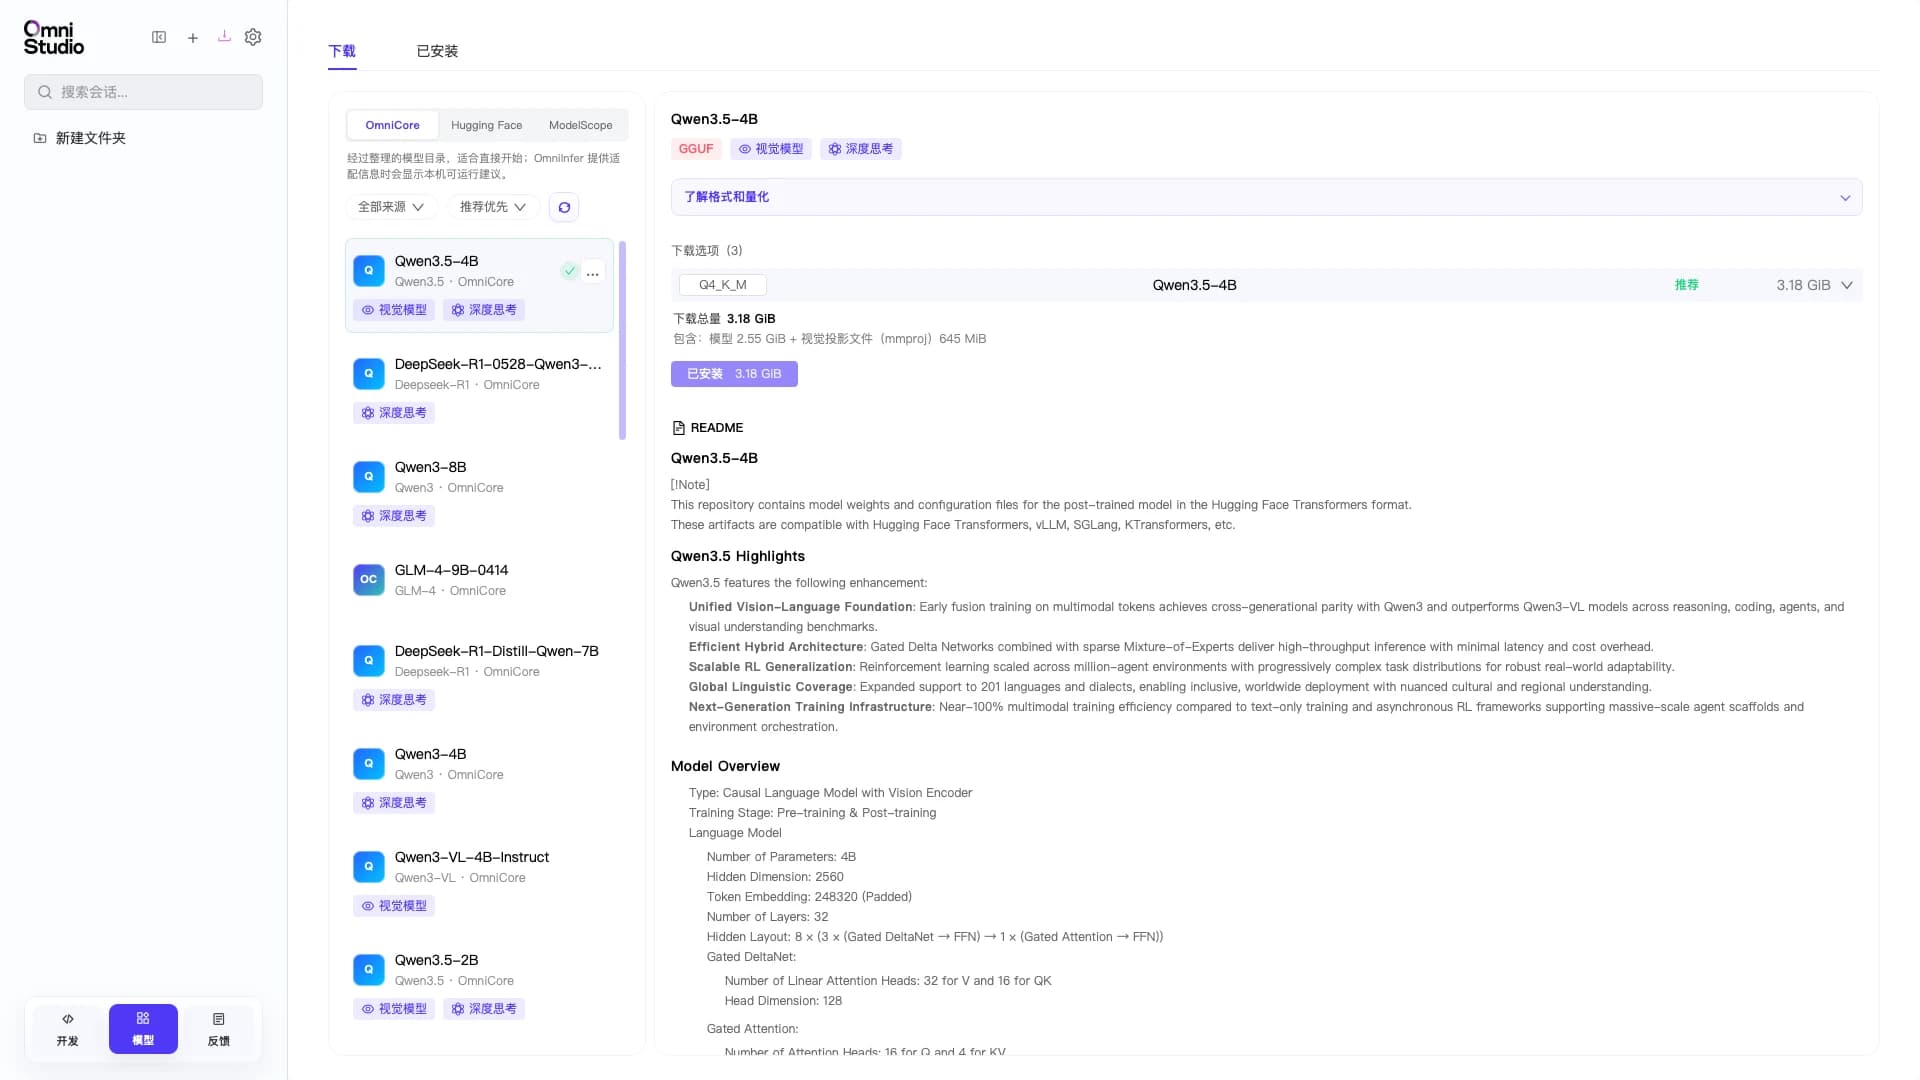
OmniStudio 原生客户端模型管理界面,Qwen3.5-4B Q4_K_M 及视觉投影文件已安装

本地模型,一站接入

从模型选择、下载到本地运行与接入,在统一界面完成模型管理、运行与调用,减少重复配置与工具切换。

从使用文档开始
  1. 01

    选择模型

    查看来源与量化版本

  2. 02

    下载并加载

    在本机准备运行环境

  3. 03

    开始使用

    图文对话或 API 调用

核心能力

从模型管理,到应用接入

模型管理

模型部署更便捷

在同一界面管理模型来源、下载进度、量化版本与本地文件,减少配置和工具切换。

查看使用文档
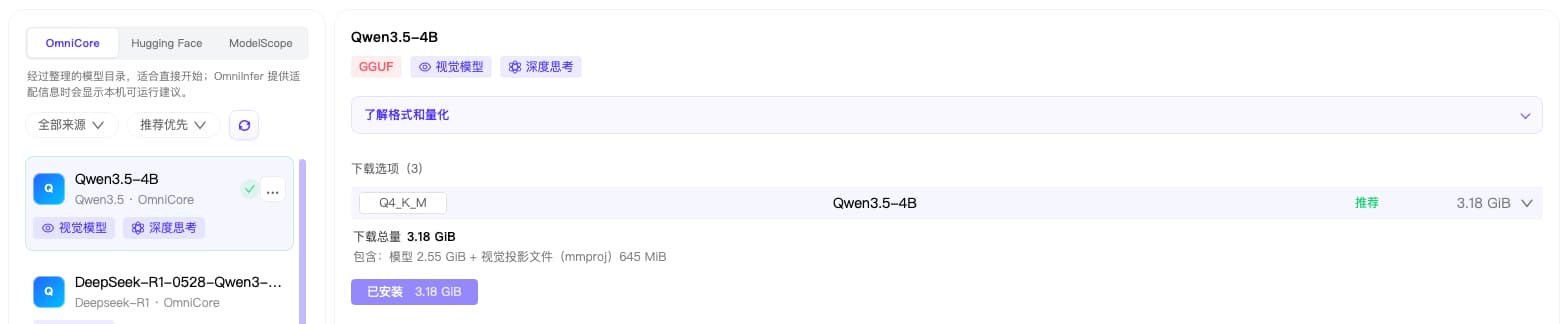
模型目录中选中 Qwen3.5-4B,Q4_K_M 主模型与视觉投影文件总计 3.18 GiB,状态为已安装
放大查看细节
模型目录中选中 Qwen3.5-4B,Q4_K_M 主模型与视觉投影文件总计 3.18 GiB,状态为已安装

多模态

文本与视觉,一起使用

支持语言模型与视觉模型本地运行,在同一界面完成文本对话、图片理解与图文问答。

查看支持模型
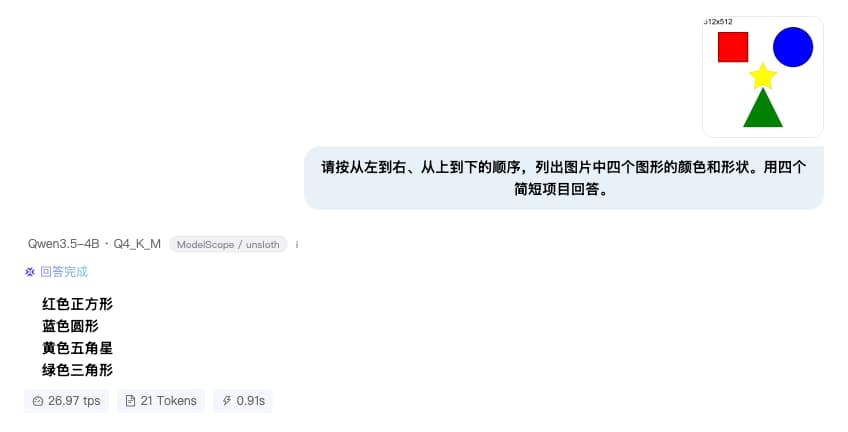
Qwen3.5-4B 图文问答:按从左到右、从上到下的顺序,回答红色正方形、蓝色圆形、黄色五角星、绿色三角形
放大查看细节
Qwen3.5-4B 图文问答:按从左到右、从上到下的顺序,回答红色正方形、蓝色圆形、黄色五角星、绿色三角形

应用接入

OpenAI 兼容 API

将本地模型接入开发工具、业务应用和自动化流程,减少从云端 API 迁移的改造成本。

查看 API 文档

本地 API · 请求示例

先在 OmniStudio 中加载模型,再在同一台电脑查询模型 ID:

curl http://127.0.0.1:19157/v1/models

用返回的 data[].id 替换 <MODEL_ID>,保存为 api-request.json。

查看请求 JSON
{
  "model": "<MODEL_ID>",
  "messages": [
    {
      "role": "user",
      "content": "请用一句话解释什么是本地模型推理。"
    }
  ],
  "stream": false,
  "max_tokens": 128,
  "temperature": 0,
  "chat_template_kwargs": {
    "enable_thinking": false
  },
  "reasoning_format": "none"
}
curl --fail-with-body --silent --show-error \
  http://127.0.0.1:19157/v1/chat/completions \
  -H 'Content-Type: application/json' \
  --data-binary @api-request.json

示例核验于 OmniInfer 0.3.30 / llama.cpp-mac。chat_template_kwargs 与 reasoning_format 是该后端扩展,不保证其它兼容服务支持。
推理引擎

OmniInfer 本地推理引擎

面向 CPU、GPU 等本地环境,持续优化模型加载、运行与资源占用。具体表现可查看已审核实测。

查看性能实测
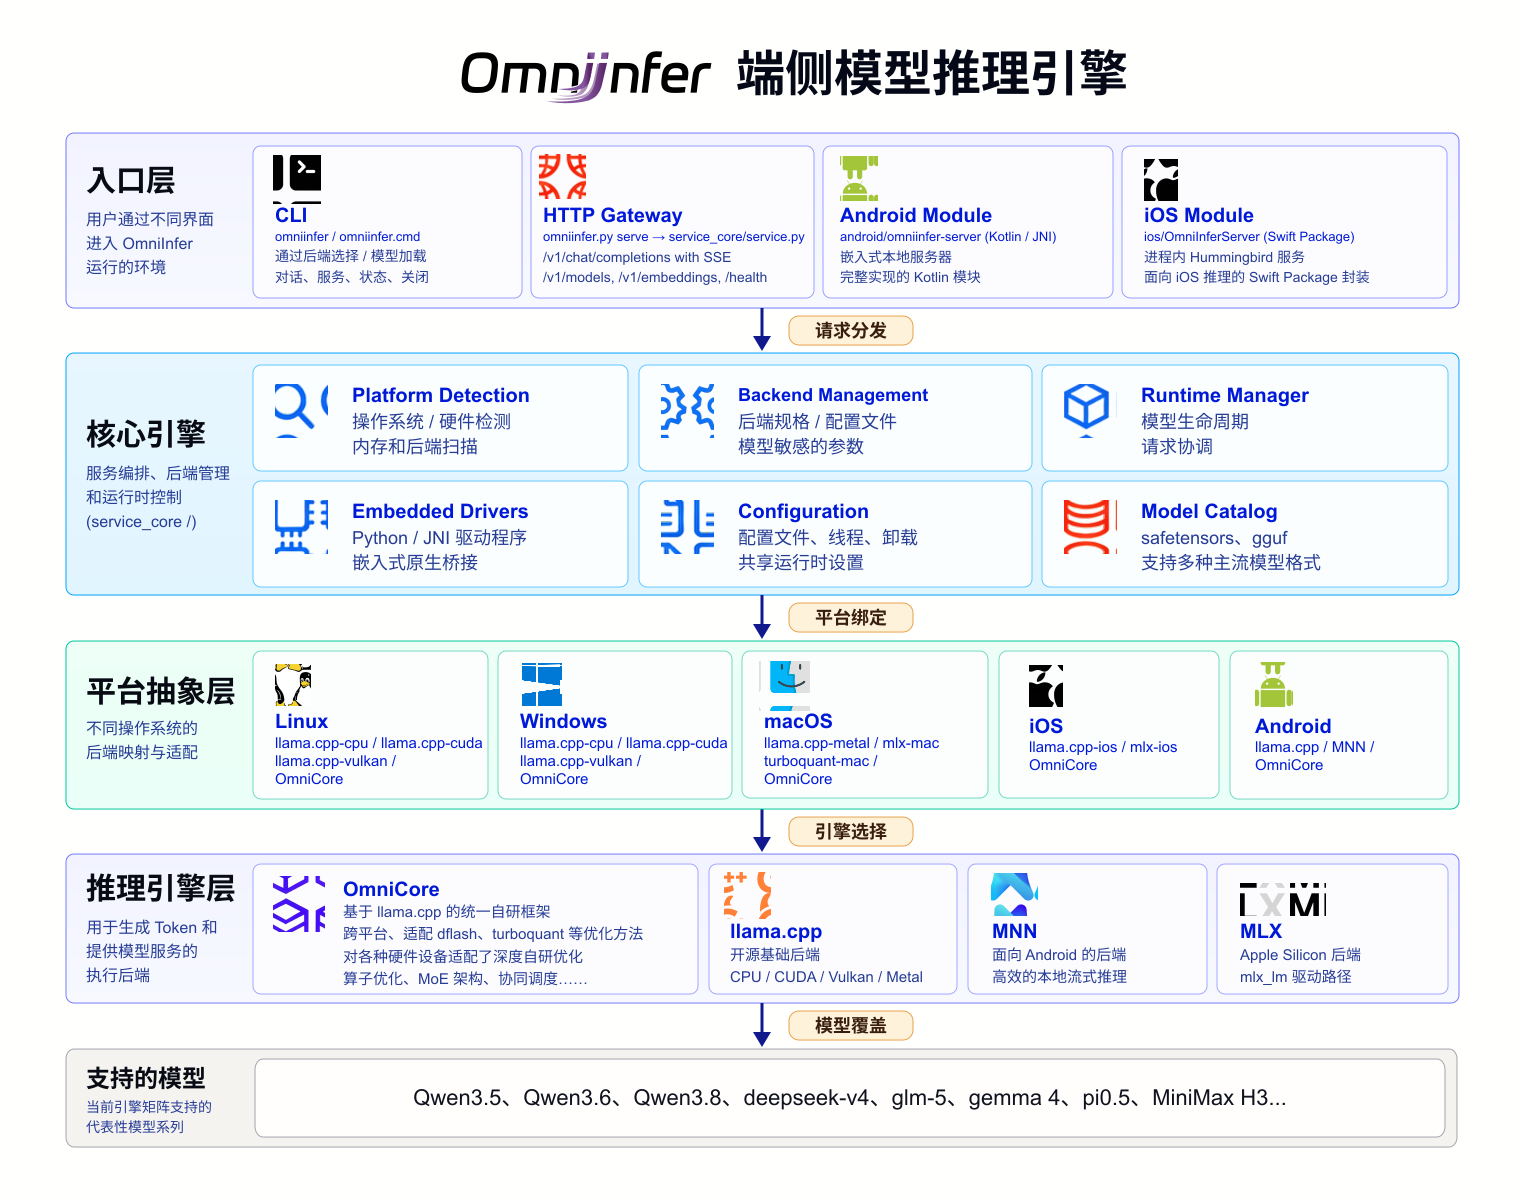
OmniInfer 端侧模型推理引擎架构:入口层经请求分发连接核心引擎,通过平台抽象层选择 OmniCore、llama.cpp、MNN、MLX 等推理引擎,最后连接支持的模型
放大查看细节
OmniInfer 端侧模型推理引擎架构:入口层经请求分发连接核心引擎,通过平台抽象层选择 OmniCore、llama.cpp、MNN、MLX 等推理引擎,最后连接支持的模型

Powered by OmniInfer

OmniInfer 推理生态

在同一站点查看模型目录、平台支持与性能实测。

查看 OmniInfer 项目
OmniStudio